


Nie pozwól, aby przepływy pracy sprężyste cię spowolnić! Nasze ja - opracowało wydajność narzędzi o prawie 10 razy
Tło rozwojowe: pochodzące z rzeczywistych potrzeb produkcyjnych
Przetwarzanie dokumentów przed prasą do drukowania cyfrowego zajmuje zbyt dużo czasu. Po komunikowaniu się z operatorami linii frontowej zidentyfikowano i potwierdzono trzy podstawowe wymagania.
(1) Numery stron dokumentów sprawdzania partii: W druku i składaniu często konieczne jest upewnienie się, że numery dokumentów są nawet nawet, w przeciwnym razie może to prowadzić do marnowania materiałów drukowania lub błędów wiązania.
(2) Automatycznie przetwarzaj dziwne dokumenty strony: W przypadku dokumentów o dziwnych stronach pusta strona powinna być jednolicie dodana na końcu, podczas gdy dokumenty z nawet stronami powinny pozostać niezmienione.
(3) Sprawdź, czy powiadomienie tekstu: aby uniknąć błędów drukowania spowodowanych brakującymi czcionkami, konieczne jest potwierdzenie, czy tekst w dokumencie został przekonwertowany na krzywe (tj. „Odkształcenie”).
Poprzez badania nad Adobe Acrobat i różnymi wtyczkami przetwarzania PDF na rynku stwierdzono, że istniejące narzędzia mają funkcje zbędne i złożone, albo nie pasują do faktycznego procesu produkcji firmy, szczególnie pod względem ryzyka bezpieczeństwa w konwersji plików. Co ważniejsze, w kraju wytwarzane w kraju podobne narzędzia często wymagają płatności, co powoduje wyższe długie koszty użytkowania terminu. Na podstawie wyżej wymienionych problemów praktycznych firma postanowiła opracować lekkie, precyzyjne i wewnętrznie kompatybilne narzędzie specjalistyczne.
Narzędzie sprawdzania i przetwarzania strony PDF
01
Podstawowe funkcje i logika osądu
Podstawowym celem tego narzędzia jest upewnienie się, że wszystkie strony wydrukowania dokumentu są równe, a jego podejście do oceny i wykonania są następujące.
(1) Mechanizm wykrywania strony: Przeczytaj metadane dokumentów PDF za pośrednictwem biblioteki PYMUPDF, aby bezpośrednio uzyskać całkowitą informacje o stronie.
(2) Logika oceny parzystości: Użyj operacji modulo (numer strony% 2), aby określić parzystość. Jeśli wynik jest 1, jest oceniany jako dziwna strona, a jeśli wynik jest 0, jest oceniany jako strona równa.
(3) Strategia przetwarzania różnicowania: jeśli jest to nieparzyste dokument, automatycznie dodaj pustą stronę o tym samym rozmiarze co oryginalny dokument na końcu dokumentu; Jeśli jest to dokument równy strony, zachowaj niezmienioną zawartość i skopiuj ją bezpośrednio do katalogu wyjściowego.
(4) Zasada przetwarzania bezpieczeństwa: wszystkie przetworzone dokumenty są zapisywane w wyznaczonym katalogu „przetworzonych plików”, a oryginalne pliki pozostają niezmienione, aby uniknąć uszkodzeń plików spowodowanych niewłaściwą atakiem, jak pokazano na rysunku 1.
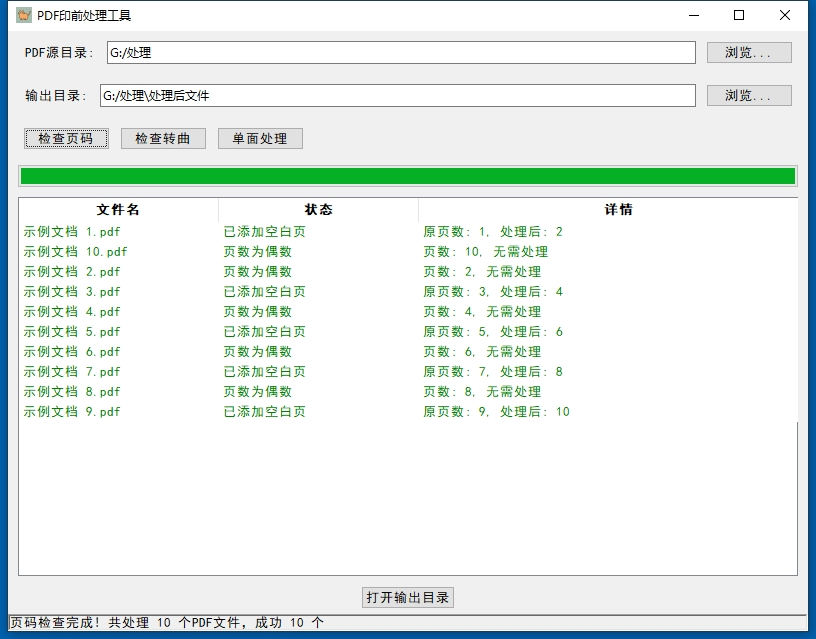 Rysunek 1 interfejs sprawdzania strony i przetwarzania strony PDF
02
Kluczowe punkty wdrożenia technicznego
Narzędzie wykorzystuje Tkinter do zbudowania interfejsu graficznego, który zawiera głównie trzy moduły funkcjonalne.
(1) Moduł wyboru katalogu: Obsługuje wizualny wybór katalogów plików źródłowych i katalogów wyjściowych, przy czym domyślny katalog wyjściowy jest podfolderami w katalogu źródłowym.
(2) Moduł przetwarzania partii: za pomocą technologii gwintowanej multi - do wdrożenia przetwarzania zaplecza, unikania opóźnień interfejsu i wyświetlania postępów przetwarzania w czasie - przez pasek postępu.
(3) Moduł wyświetlania wyników: Przedstaw wyniki przetwarzania każdego pliku w formacie tabeli, w tym oryginalny numer strony, działania przetwarzania i informacje o stanie, oraz rozróżnij stany udane i nieudane według koloru.
Narzędzie sprawdzania konwersji PDF
01
Podstawowe funkcje i logika osądu
Narzędzie sprawdzania krzywej koncentruje się na ustaleniu, czy tekst w dokumencie został przekonwertowany na krzywą, a jego podstawowa logika osądu opiera się na analizie informacji czcionek w dokumentach PDF.
(1) Wykrywanie obecności tekstu: za pomocą funkcji ekstrakcji tekstu strony ustal, czy dokument zawiera tekst edytatywny.
(2) Analiza informacji czcionek: Przeanalizuj listę osadzonych czcionek w dokumencie. Jeśli istnieją informacje o czcionkach, wskazuje, że tekst nie został przekonwertowany.
(3) kompleksowa zasada osądu: jeśli istnieje treść tekstowa, ale nie ma informacji o czcionce, wskazuje, że utwór został przekonwertowany (oznaczony na zielono); Brak treści tekstowej, wskazując, że nie ma potrzeby przełączania ścieżek (zielona etykieta); Jeśli istnieje treść tekstu i informacje o czcionkach, wskazuje, że utwór nie został przekonwertowany (oznaczony na czerwono), jak pokazano na rysunku 2.
Narzędzie jest specjalnie zaprojektowane do trybu „jedyne sprawdzenie bez konwersji”, głównie dlatego, że zgodnie z operatorami operatorów, podczas wykonywania operacji konwersji na plikach zawierających oficjalne uszczelki, łatwo jest spowodować utratę oficjalnych fok i innych wzorów. Dlatego zachowana jest tylko funkcja kontroli.
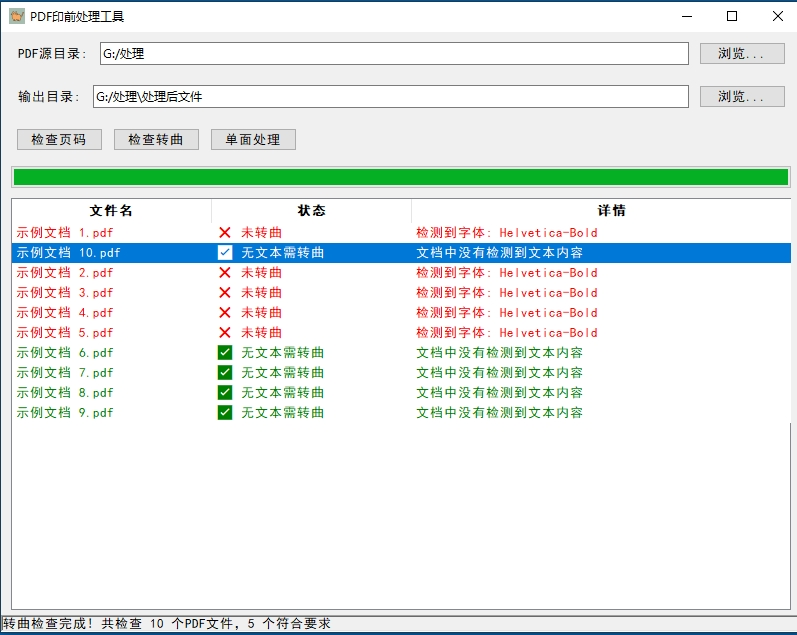 Rysunek 2 Narzędzie kontroli konwersji PDF
02
Kluczowe punkty wdrożenia technicznego
To narzędzie wykorzystuje również Tkinter do budowy interfejsu, a kluczowe punkty techniczne obejmują następujące trzy punkty.
(1) Ekstrakcja informacji czcionek: Za pomocą funkcji analizy bloku tekstu PYMUPDF uzyskaj nazwy i występowanie wszystkich czcionek używanych w dokumencie.
(2) Wizualizacja wyników: Użyj widoku drzewa, aby wyświetlić wyniki kontroli i wizualnie rozróżnić różne stany poprzez kolory i ikony.
(3) Statystyka stanu Funkcja: automatycznie oblicz liczbę plików spełniających wymagania, pomagając operatorom szybko uchwycić ogólną sytuację inspekcji.
Trudności i rozwiązania w procesie rozwoju
Jako nie profesjonalny programista napotkałem wiele wyzwań technicznych podczas procesu rozwoju narzędzi. Konkretne problemy i rozwiązania są następujące.
(1) Wydanie głębokości parsowania PDF: Początkowa zastosowana biblioteka PDF nie była w stanie dokładnie wyodrębnić informacji o czcionkach. Po zaleceniu AI został rozwiązany przez zastąpienie go biblioteką PYMUPDF.
(2) Problem opóźnienia interfejsu: Podczas przetwarzania dużej liczby plików luzem interfejs jest podatny na stany niereagujące. Przy wskazówce AI zaimplementowano rozwiązanie do przetwarzania w gwintowanych wątku w celu skutecznego rozwiązania tego problemu.
(3) Chińskie wyświetlacze zniekształcone znaki: Konfigurowanie parametrów czcionek i kodowania ustawień, problem chińskich wyświetlaczy zniekształconych znaków w interfejsie i eksportowanych plikach został rozwiązany.
(4) Mechanizm obsługi wyjątków: W odpowiedzi na problem awarii programu spowodowany uszkodzonymi plikami PDF ulepszono mechanizm przechwytywania wyjątków, aby zapewnić, że niepowodzenie indywidualnego przetwarzania plików nie wpłynęło na ogólny proces.
W trakcie procesu rozwoju narzędzia AI odgrywały ważną rolę konsultantów technicznych, podając nie tylko przykłady kodeksu kluczowego, ale także wyjaśniając zasady analizowania formatu formatów plików PDF, pomagając programistom szybko zrozumieć zawodową wiedzę na temat domeny.
Wartość i perspektywa aplikacji narzędziowej
Zastosowanie tych dwóch narzędzi spowodowało znaczną poprawę wydajności w pracach produkcyjnych, które znajdują odzwierciedlenie w następujących dwóch aspektach.
(1) Oszczędność kosztów czasowych: Prace inspekcji ręcznej, które pierwotnie wymagały 1 godziny, można teraz ukończyć w 5 minut, zwiększając wydajność o prawie 10 razy.
(2) Ulepszona stabilność jakości: Skuteczne unikanie pominięć inspekcji ręcznej i zapewnienie stabilnej jakości drukowania.
Nagrywanie procesu rozwoju tych dwóch małych narzędzi ma na celu przekazanie filozofii pracy „eksploracji i innowacji”, skupienie się na rozwiązywaniu konkretnych problemów w rzeczywistej produkcji, optymalizacji tradycyjnych przepływów pracy za pomocą środków technologicznych i ostatecznie osiągnięcia celu zmniejszenia kosztów i poprawy wydajności.